Perslis 国防
PERSLIS 国防 · 演化 · 失败优先

它自己写规则。

这正是 Peel 与其他符号系统的区别。规则引擎或专家系统运行的是人写、人维护的规则;世界一变,就得有人去改写。Peel 自己写。每一次失败都被记录并解释,Peel 提出一条新规则,正面对比测试,明显胜出就把规则写下来——用平实的语言,连同赢得它的那些失败——从此按它学习。

它是一个无权重模型,采用失败优先架构:没有神经网络,不需要重新训练,不需要数据中心。它从一小套手写的基础出发;此后的每一条规则,都由它自己写下。它靠失败变强。

实时录制:大脑演化时的 DOOM 控制台。鼠标移上去即可放大。右下角从追踪中归纳的规则:它从自己的失败中亲手写下的规则——没有人替它输入。

如何起步:我们和你一起写下第一批规则

  1. 我们一起写起步规则,一直写到足以起跳。在任何演化开始之前,我们和你一起为这项任务写规则——怎么动、要避开什么、绝对不能做什么——一直写到大脑能够独立完成任务,哪怕做得很差。这就是起跳点:从那以后,它自己的失败开始教它。整套规则由你签字确认。
  2. 然后交给演化。此后的每一次失败都会被解释、正面对比测试,并在你们商定的规则之上变成新规则——被标为限制的那些,它永远不能放宽。
  3. 写一次,每架无人机都有。大脑是一个密封文件。为一架无人机写好的起步规则,就是整个机队每一架的起步规则;一架证明了的东西,其余的都能继承。

一个空白的大脑不会自己演化。没有写下任何规则,它根本做不了这项任务,也就没有东西可以拿来对比测试、没有可以学习的对象——所以我们总是先写规则,一直写到足以起跳。本页的每一个游戏都是这样开始的:先是手写规则,然后在其上演化。在真实机队之间共享一本规则书还没有展示过;在两款坦克游戏之间移动一个大脑已经展示过。

无权重模型

神经模型它知道的东西是数十亿个权重。学点新东西就要在数据中心里重新训练这些权重。没人能指出是哪个权重做出了某个决定。
Peel它知道的东西是显式状态:它经历过的情境、它尝试过的做法、结果如何,以及它写下的规则。学习就是在机器上增加或砍掉一条规则。每条规则都引用赢得它的那些失败。

失败优先架构

大多数 AI上线之前训练好,然后冻结。现场的一次失败要等下一轮重新训练,而且大多数 AI 被训练成根本不让你看到它的失败。
Peel建立在失败之上。每一次失败都被解释,针对它正面测试一个改变,只有明显胜出才保留——然后 Peel 在任务途中把它写进自己的规则书。

一次被解释、被测试并变成规则的失败,就不会以同样的方式重演。在 Fallout 中,开启学习后,同一存档、同一种子,从每小时 80 次死亡降到 15 次。

把你的失败交给它

你的项目手里已经握着最有价值的训练数据:每一次失败的侦察任务、每一架坠毁的无人机、每一份事故报告。成千上万次无人机失败不是损失——它们就是你真正需要的那台机器的规则书。

我们用你的失败来绘制卡片。系统的每个决定都从一组卡片中选出——情境、在那里允许的动作、每个动作以前导致了什么。你的失败记录就是我们绘制这些卡片的依据:每一次失败都告诉系统,下次处于同样情境时该怎么做。失败记录越多,能绘制的卡片越多,我们能用来打造一个真正管用的失败优先系统的材料也就越多。

  1. 交来记录。任务日志、遥测、传感器航迹、任务简报、坠毁与维修数据——不管它存在什么老格式里。
  2. 它梳理出哪里出了错。对每一次失败的任务,它写明发生了什么、为什么、本该学到什么——一份书面的战后行动计划,与证明它的记录挂钩。
  3. 它把教训变成规则。每条教训变成一条规则,正面对比测试,只有明显胜出才保留——下一台机器第一天就带着全部规则上阵,包括受人指挥、具备武器能力的平台。

我们已经用公开记录做过一次:8,219 份美国联邦关于自动驾驶车辆的撞车与事故报告,变成了 15 条驾驶规则,每一条都与赢得它的记录挂钩;目前已强制执行 6 条。军事侦察和无人机失败数据还没有跑过——那是下一步。

这 15 条规则从哪里来 →

失败如何变成规则

  1. 它失败。 一次死亡、一次撞击、一次停滞、一次没看到的打击。每一次都连同发生时的情境记录下来。
  2. 它解释失败。 追踪一路回溯它看到了什么、选择了什么。
  3. 它提出一个改变。 只有一个。不是重新训练,不是新模型:一条规则、一个选择上的权重、或砍掉一个行为。
  4. 它和自己对打。 老办法和新办法在同一关卡、同一种子上正面对打,一遍又一遍。
  5. 只保留明显的赢家。 只有在反复对比中明显胜出(z ≥ 2)才保留。输了(z ≤ −1)就扔掉。其余一律未证明。
  6. 它把它写下来。 保留下来的规则写进一本你可以打开阅读的规则书,连同赢得它的那些失败。
证据 · 逐个游戏

在我们运行的每一个游戏里,学习如何演化。

13 条线路,于 2026-09-29 16:24 从各自的证据文件中提取。其中 7 条显示大脑在变好;其余的持平、有涨有平,或根本不是学习者——它们也在这里。只展示进步的部分只是集锦,不是证据。

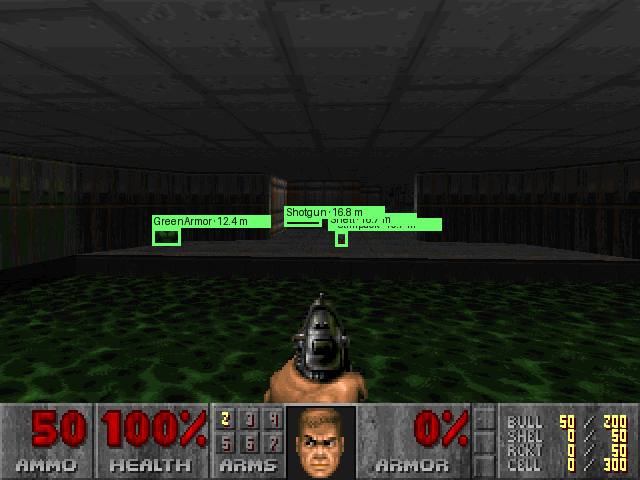
画面来自 Doom

Doom有涨有平

在 E1M5 上,飞行员参数未变,路线进度翻了一倍多(z +7.88),同一时间段内我们也对这条线路做了修复。在 E1M3 上,两个难度都持平。

学到的,还是我们构建的? 混合. 主要由我们构建。飞行员参数没有改变(80 次对照尝试全部是 v2),演化器在这里的 8 个候选中保留了 0 个。同一时间段内,我们的干预账本记录了 51 次人工改动(44 次修复、6 个新增原语、1 条人写不变式);其中 17 次点名 E1M5(1190d66, 1c28a66, 1f91f18, 2db50f8, 325869e, 384f4ff …)。上升中有多少来自它自己的记忆、多少来自这些修复,没有测量。

路线进度(每组平均) by 对照尝试(分组): E1M5 · normal skill 0.2 → 0.68; E1M3 · normal skill 0.42 → 0.33; E1M3 · hard skill 0.08 → 0.0600.340.68E1M5 · normal skill 0.68E1M3 · normal skill 0.33E1M3 · hard skill 0.06对照尝试(分组)路线进度(每组平均)
  • 很快通过 E1M1 → E1M2 → E1M4;E1M3 用了 335 次尝试
  • E1M5 尚未到达出口
  • 命令、武器与危险地板都在控制台中实时运行

证据: doom-floor/evidence/evolve/doom-s1/attempts.jsonl
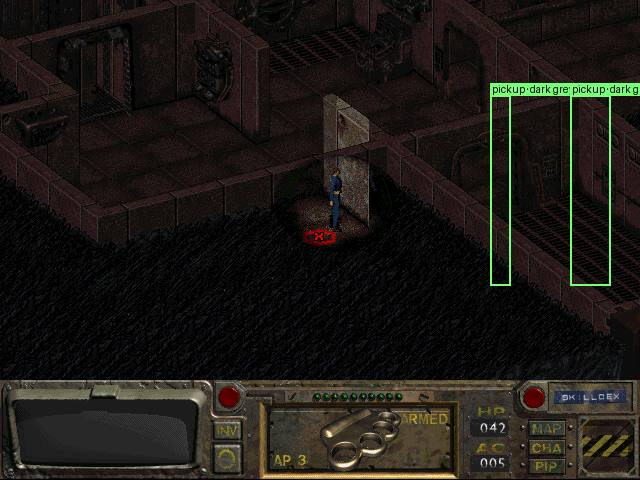
画面来自 Fallout(1997)

Fallout(1997)学习后进入平台期

经验值 300 → 2,660,并靠自己的游戏升了一级。学习开 vs 关,同一存档、同一种子、各 12 分钟:每小时死亡 15 次 vs 80 次。

学到的,还是我们构建的? 混合. 经验值:混合——获得这些经验值期间,我们向 fallout-floor 提交了 112 次改动;这条线路没有干预账本,所以两者的比例没有记录。每小时死亡 A/B:系统学到——两组运行同样的代码、存档和种子,只有学习开关不同。

持有经验值 by 游戏小时数(有记录): XP 300 → 2,66001,3302,660XP 2,660游戏小时数(有记录)持有经验值每小时死亡(A/B,各 12 分钟): 学习开 · 实时记忆 15; 学习关 · 实时记忆 80; 学习开 · 空记忆 30; 学习关 · 空记忆 80学习开 · 实时记忆15学习关 · 实时记忆80学习开 · 空记忆30学习关 · 空记忆80每小时死亡(A/B,各 12 分钟)
  • 飞行员完成了 11 个战役步骤
  • 现在卡在一个任务上已有好几个小时——照实展示,不隐藏

证据: fallout-floor/maps/journal.json

无人机赛道(MuJoCo)在学习

87 轮中,最佳无碰撞单圈 39.4 秒 → 27.8 秒。从留出的起点出发:学习后 10/10 圈无碰撞、0 次接触;未学习 0/10、18 次。

学到的,还是我们构建的? 系统学到. 系统学到:循环在它提出的 86 个改变中接受了 17 个,其余否决。它可以尝试的改变种类(每段的高度与速度)以及评分所用的代价由我们编写(drone-floor b5e5a69);各轮之间没有记录任何人工改动(整个运行在 b5e5a69 中提交;各轮没有时间戳)。

最佳无碰撞单圈(秒) by 轮次: lap 39 → 2802039lap 28轮次最佳无碰撞单圈(秒)
  • 在 2–3 米/秒的追逐速度下,学到的路线仍会卡住或坠毁

证据: drone-floor/evidence/trial_rounds.jsonl

BZFlag在学习,仍然输

对阵 BZFlag 自带 AI 的每分钟净击杀:v2 -1.17,v3 -0.43,v4 -0.26;v0 是从不开火的参照,-2.05。v2 为手写版本;v3、v4 为循环晋升的版本,每次都通过了成对检验。它仍然输。

学到的,还是我们构建的? 混合. 混合。v2 由我们手写。v2 → v4 的提升来自循环自己的晋升(v3 = v2+dodge_miss_m=6.0, v4 = v3+juke=False),每一次都由成对检验保留。从第一次试验到 v4 之间,我们向循环的死因分析、基因菜单与计分提交了 8 次改动(6f76e6a, 4640940, 3744c9f, c7944b5, 5fd7e3b, 27a115d, 07a04e2, 96259ea);它们影响了它尝试什么,而不是它保留的取值。

对阵 BZFlag AI 的每分钟净击杀: v0 参照(1 场) -2.05; v2(8 场) -1.17; v3(1 场) -0.43; v4(3 场) -0.26v0 参照(1 场)-2.05v2(8 场)-1.17v3(1 场)-0.43v4(3 场)-0.26对阵 BZFlag AI 的每分钟净击杀
  • 我们的飞行员通过客户端的自动驾驶接口驾驶——屏幕上的标签是 BZFlag 的
  • v4 之后又有 24 次试验未被证明,循环自行停止

证据: bzflag-floor/evidence/pilots/evolution.jsonl

眼睛(BZFlag 画面)在学习,但不是直线

眼睛在同样的 7,863 帧上学习“见证”目标的六轮。召回率下降的同时误确认也在下降;只有最后一轮通过闸门。

学到的,还是我们构建的? 由我们构建. 由我们构建。每一轮都是我们给眼睛加上的一个特征(即上面的轮次名称);画面与闸门保持不变。bzflag-floor 中的提交 30401f2、809380b、33fbf3b、26ebf85。

召回率(%) by 学习轮次: recall 96 → 9804998gate 98recall 98学习轮次召回率(%)
轮次召回率误确认闸门
first witness96.1%1.14%fail
+ glow clues79.5%0.53%fail
+ shots masked78.3%0.15%fail
+ engine flags78.3%0.15%fail
+ decision trees92.7%0.23%fail
+ turret layout98.4%0.46%PASS
  • 闸门:召回率 ≥ 98% 且误确认 ≤ 0.5%

证据: bzflag-floor/evidence/eye-gate/evolution-teacher4.json

BattleZone(Atari)靠迁移与修剪提升

一个在 BZFlag 中训练的大脑移入 BattleZone:80 个种子上 33,575,原生规则为 28,600。凭证据修剪后:80 个全新种子上 48,588 vs 29,275。

学到的,还是我们构建的? 混合. 迁移(+17%):由我们构建。移入的大脑是 bzflag-v2,即手写的 BZFlag 飞行员,经由我们写的导出与身体适配器(vdsg-brain 429e34b);这个数字里没有任何东西是在 BattleZone 中学到的。修剪后:混合。修剪程序由我们编写(737c2f8);砍掉什么,由它自己的使用统计与剔除检验决定,作用对象是 v4——它带有两次在 BZFlag 中由循环晋升的改变。

平均得分,80 个全新种子: 原生规则 29,275; 迁移的大脑 28,975; 迁移 + 修剪 48,588原生规则29,275迁移的大脑28,975迁移 + 修剪48,588平均得分,80 个全新种子
  • 第二次导出(v4)在全新种子上与原生规则持平——迁移并非自动成立
  • 演化器自己的参数搜索在这里没有晋升任何东西

证据: vdsg-brain/evidence/battlezone/transfer.jsonl

Space Invaders(Atari,原始像素)先升后降

没有规则时平均 162 分 → 最佳 276 分 → 100 局后 247 分。规则越多并不总是越好。

学到的,还是我们构建的? 归因未记录. 归因未记录:这条线路没有干预账本,因此无法说明学到的部分与我们构建的部分各占多少。

平均得分,12 个留出种子 by 经验局数: score 162 → 2470138276score 247经验局数平均得分,12 个留出种子
  • Freeway 用同一机制,下降 12%——照实发表,没有调参掩盖

证据: invaders-floor/web/curve.json

Doom · 演化器自己的账本门槛严格

系统为自己提出了 42 个改变;1 个赢得晋升。其余被否决或仍未证明——包括我们自己的 Peel 追踪地板。

学到的,还是我们构建的? 系统学到. 系统学到:晋升(t11 (EXPLORE_DRY 0 → 1, z 2.26))由演化器提出,并由它自己的成对检验保留。它能尝试的基因取值由我们加入(doom-floor 5cb8477、a6943e9)。

改变数: 晋升 1; 否决 9; 未证明 31; 无效 1晋升1否决9未证明31无效1改变数
  • 晋升需要在同一关卡、同一种子的成对尝试中 z ≥ 2
  • z ≤ −1 即否决

证据: doom-floor/evidence/evolve/doom-s1/rounds.jsonl

GoldenEye 007(N64)持平

在 Dam 上进度一直在 0.06 左右;72 次尝试中 0 次存活。它确实发明并晋升了 2 个优于规则默认动作的战术。

学到的,还是我们构建的? 系统学到. 这 2 个战术:系统学到——由这条线路自己的成对检验发明并保留。在这些尝试期间,我们的干预账本没有记录针对 GoldenEye 的修复,但记录了 39 次对它所运行的共享 Doom 框架的人工改动。

路线进度 by 每 10 次对照尝试一组: Dam 0.06 → 0.0600.030.07Dam 0.06每 10 次对照尝试一组路线进度
  • 已晋升:“keep aim on the target”(z 2.03)
  • 已晋升:“strafe away from the target, keep aim on the target, fire when on target”(z 2.13)

证据: goldeneye-floor (lane home)/evidence/evolve/goldeneye-dam-s3-doom/attempts.jsonl

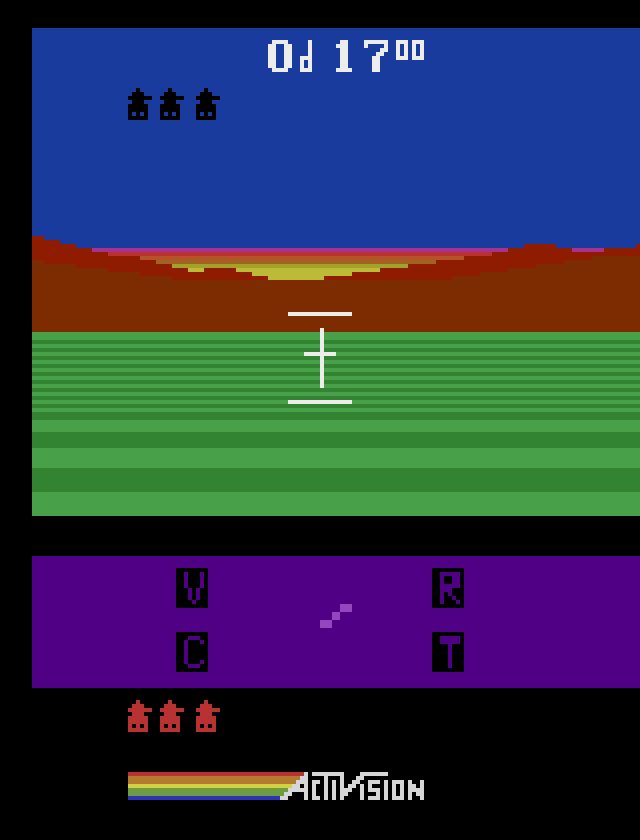
画面来自 Robot Tank(Atari)

Robot Tank(Atari)规则,不是学习

手写规则对随机操作:摧毁敌方坦克 5.67 vs 2.33(各 6 局留出对局)。这是不同方案之间的比较,不是学习曲线。

摧毁的敌方坦克: 规则 5.67; 随机 2.33; 从不开火 0规则5.67随机2.33从不开火0摧毁的敌方坦克

证据: robotank-floor/evidence/eval.jsonl

Quake III(OpenArena)未被证明

带着第一轮的记忆重玩地图:t = 2.02,p = 0.079。学习未被证明,我们照实说。

  • v1 中机器人下方的地板在修复前曾导致熔岩死亡

证据: quake-floor/RESULTS.md

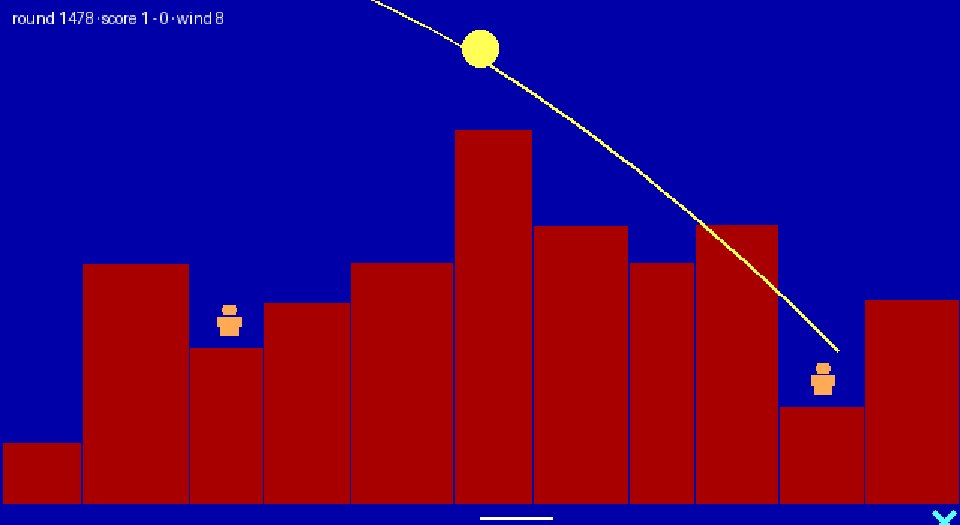
画面来自 Gorillas(QBasic,1991)

Gorillas(QBasic,1991)没有学习趋势

物理求解器第一投就命中;逐步修正投掷的学习器 10 投中 2,没有趋势。

  • 真实的 GORILLA.BAS,通过我们加入的接口驱动

证据: gorillas-floor/tests/fixtures/throws.json

Wolfenstein 3D没有学习记录

只有规则与导航:它能打通关卡,但这条线路还没有保存证据记忆。

证据: wolf-floor/wolf_floor/console.py

游戏名称与画面归其所有者所有,此处用于研究评论。画面均来自我们自己的运行。

Perslis 全站